1. Ce que nous avons testé
En 2025-2026, la génération vidéo par IA a connu une croissance explosive, avec l'apparition constante de nouveaux modèles. Plutôt que de juger sur les spécifications et les argumentaires marketing, nous avons préféré les essayer nous-mêmes : nous avons pris la même tâche et le même jeu de prompts pour dérouler quatre scénarios sur six plateformes.
Plateformes testées :
Interface web : Kling 3.0, HappyHorse 1.0, Veo 3.1 Fast
Accès API : Seedance 2.0, Dreamina Video 3.0, Xiaoyunque
Outil d'appoint : Dreamina 5.0 Lite (pour générer l'image de référence du personnage).
Remarque : dans les benchmarks tiers, le classement des modèles concernés ici est Seedance 2.0 > HappyHorse 1.0 > Kling 3.0 > Veo 3.1 Fast. Ce classement reflète le score global du benchmark ; l'expérience réelle varie selon le scénario.
━━━━━━━━━━━━━━━━
2. Le protocole de test
Tous les prompts ont été envoyés en anglais ; les descriptions en chinois ci-dessous ne servent qu'à faciliter la compréhension.
◆ Test A : scène statique — terre désolée au crépuscule
Une petite communauté installée dans les ruines d'une guerre nucléaire, au crépuscule. Les silhouettes de tours brisées apparaissent faiblement dans la lueur rose-violet d'une poussière radioactive, et une tour de purification d'eau rouillée renvoie un reflet aveuglant sous le soleil couchant. Le sol est couvert d'une poussière radioactive gris-blanc ; quelques silhouettes drapées de vieux tissus traversent lentement les ruines. Composition cinématographique en grand écran, esthétique post-apocalyptique, style hyperréaliste.
Dimensions observées : l'ambiance, la composition et l'exactitude des détails (la poussière radioactive, la rouille, la tour de purification d'eau sont-elles fidèlement reproduites).
Résultats :
Kling 3.0 — forte sensation d'immersion
Veo 3.1 Fast — bonne texture
Seedance 2.0 — mouvement de caméra intégré
Dreamina Video 3.0 — correct, sans plus
HappyHorse 1.0 — correct, sans plus
Xiaoyunque — un sens du récit constamment plus marqué (grâce à sa durée de génération de 15 secondes)
◆ Test B : action dynamique — nettoyer un verre dans la taverne
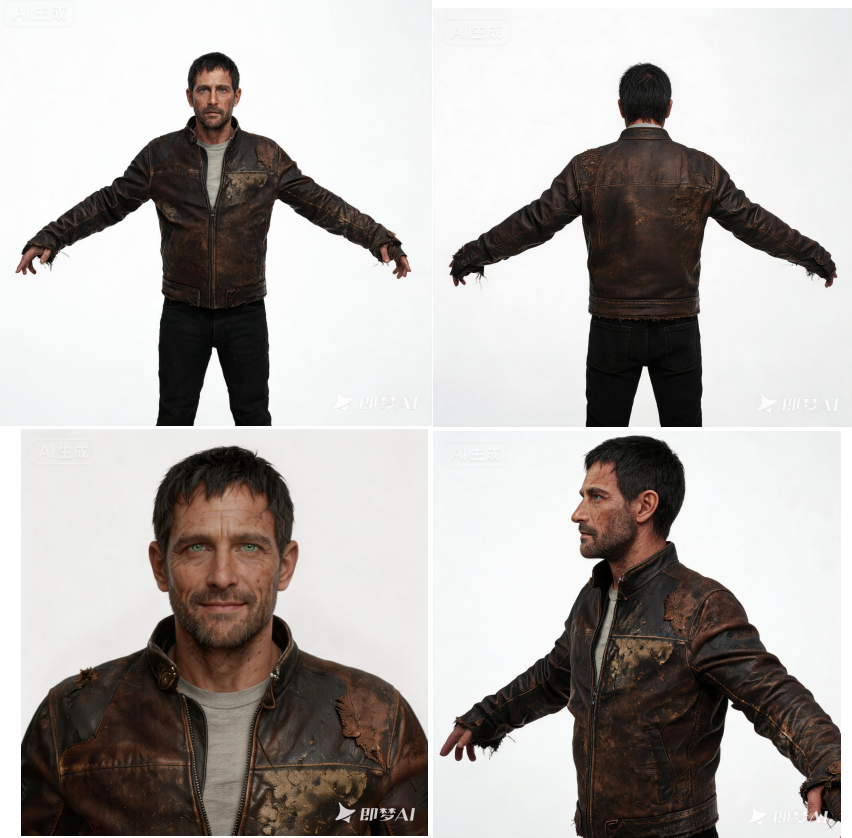
Dans le comptoir sombre d'une taverne de la désolation, un homme d'environ 35 ans, « Galen Ash », baisse la tête et essuie une coupe en métal avec un vieux chiffon. Il porte une vieille veste en cuir marron foncé ; son visage est marqué et ses yeux d'un gris-vert. Il lève la coupe sous une lampe à huile et la fait tourner pour l'examiner, la repose, puis lève les yeux vers la caméra, le coin des lèvres légèrement relevé, le regard méfiant et calculateur. Gros plan, travelling avant lent, éclairage cinématographique.
Dimensions observées : la stabilité du personnage (le visage se déforme-t-il), la continuité du mouvement, le regard et l'expression, la texture de l'éclairage.
Résultats :
Kling 3.0 — micro-expressions insuffisantes
Veo 3.1 Fast — texture à fort contraste, mais les micro-expressions ignorent totalement les consignes
Seedance 2.0 — l'expression passe, mais le clip est trop court pour terminer la performance
Dreamina Video 3.0 (noté à tort seedance3.0 dans la vidéo) — un mouvement un peu raide
HappyHorse 1.0 — les micro-expressions les plus naturelles ; correct dans l'ensemble
Xiaoyunque — un fort sens du récit
◆ Test C : image vers vidéo — cohérence du personnage
À partir de l'image de référence de Galen Ash téléversée, générer le personnage tournant la tête vers la droite, puis revenant lentement face à la caméra, tandis que sa main gauche sort un vieux pistolet de sous le comptoir et le pose sur la table. Garder le visage, les vêtements et la coiffure du personnage exactement identiques à l'image de référence.
Dimensions observées : la cohérence du visage, des vêtements et de la coiffure du personnage avec l'image d'origine, le mouvement de rotation, le mouvement de la main.
Image de référence :
Résultats :
Kling 3.0 — cohérence du personnage correcte et mouvement naturel, mais le personnage ne finit jamais face à la caméra
Veo 3.1 Fast — non réalisé (quota gratuit épuisé)
Seedance 2.0 — non réalisé (image de référence refusée)
Dreamina Video 3.0 — n'a pas participé
HappyHorse 1.0 — cohérence du personnage correcte avec mouvement de caméra intégré ; correct
Xiaoyunque — n'a pas participé
◆ Test D : récit complexe — la fuite et la trahison
Une rue en ruine dans la désolation : Galen jaillit d'un bâtiment effondré et court vite sur les gravats. Il jette un regard derrière lui (la caméra suit), son visage change et il accélère. Il saute par-dessus un pilier de béton effondré, roule une fois en atterrissant, ramasse une boîte métallique rouillée au sol, puis se glisse dans l'ombre du bâtiment voisin, dos au mur, respirant fort, les yeux pleins de peur et de colère. Plan-séquence, style caméra à l'épaule, plusieurs actions en continu.
Dimensions observées : l'enchaînement de plusieurs actions, l'expressivité des mouvements de caméra, les collisions physiques (courir / sauter / rouler), l'expression des émotions (peur et colère).
Résultats :
Kling 3.0 — suit les consignes ; correct
Veo 3.1 Fast — non réalisé (quota gratuit épuisé)
Seedance 2.0 — fluide dans l'ensemble
Dreamina Video 3.0 (noté à tort seedance3.0 dans la vidéo) — la course du personnage n'est pas naturelle, avec des traces d'IA évidentes
HappyHorse 1.0 — le personnage ne roule pas
Xiaoyunque — correct, sans plus
Observation globale : aucune des vidéos ne restitue le suivi de caméra du « regard jeté derrière soi » ; c'est vraiment dommage.
━━━━━━━━━━━━━━━━
3. Le classement des tests
Pour les six modèles, une génération a pris entre 3 et 5 minutes. D'après les performances réelles sur les quatre scénarios de test, le classement est le suivant :
N° 1 【Seedance 2.0】(ByteDance, API Volcano Engine)
Seuil d'accès à l'API : recharge à partir de 200 yuans, ou achat d'un pack de tokens d'environ 190 yuans. C'est le modèle sous-jacent de Xiaoyunque.
Performances : mouvement de caméra intégré en A, expression validée en B, ensemble fluide en D. En C, l'image de référence a été refusée parce qu'elle était « trop proche d'une vraie personne », ce qui n'est pas une question de capacité.
N° 2 【HappyHorse 1.0】(Alibaba, interface web)
Pas de quota gratuit ; environ 4,5 yuans pour 5 secondes en 720p. Les quatre tests ont été réalisés.
Performances : les meilleures micro-expressions de tout le panel en B ; en C, cohérence correcte avec mouvement de caméra intégré. En D, le personnage ne roule pas, ce qui coûte des points.
N° 3 【Kling 3.0】(Kuaishou, interface web)
Quota gratuit disponible, et les vidéos ont leurs propres effets sonores. Les quatre tests ont été réalisés.
Performances : forte immersion en A ; en C, cohérence correcte et mouvement naturel ; en D, suit les consignes. Micro-expressions insuffisantes en B.
N° 4 【Xiaoyunque】(ByteDance / CapCut, API Volcano Engine)
Quota gratuit disponible. Agent de création de contenu, bâti sur Seedance 2.0. Durée minimale de 15 secondes (les autres plateformes démarrent à 5 secondes), à 2,13 yuans par seconde : le coût de l'essai-erreur est élevé.
Performances : fort sentiment dramatique en A et fort sens du récit en B ; correct en D. Le minimum de 15 secondes donne globalement un sens du récit plus marqué.
N° 5 【Veo 3.1 Fast】(Google DeepMind, interface web)
Quota gratuit disponible ; abonnement à 99 dollars par mois. Seuls A et B ont été réalisés (C et D non testés après épuisement du quota).
Performances : bonne texture en A ; en B, les micro-expressions ignorent totalement les consignes.
N° 6 【Dreamina Video 3.0】(ByteDance, API Volcano Engine)
Quota gratuit disponible.
Performances : correct en A, mouvement un peu raide en B, et en D la course du personnage présente des traces d'IA évidentes — le plus faible de tout le panel.
Ces résultats concordent globalement avec notre classement antérieur des grands modèles de génération vidéo par IA :
Classement externe de référence (Artificial Analysis, juin 2026 ; texte-vers-vidéo avec audio)
- 1. Seedance 2.0 — 1215 ; 2. HappyHorse-1.0 — 1121 ; 3. SkyReels V4 — 1106.
- 4. Kling 3.0 1080p Pro — 1104 ; 5. Kling 3.0 Omni 1080p — 1099 ; 6. Kling 3.0 Omni 720p — 1094 ; 7. Kling 3.0 720p — 1094.
- 8. Veo 3.1 — 1093 ; 9. Sora 2 (fermé le 26 avril 2026) — 1089 ; 10. Veo 3.1 Fast — 1086.
- Ce classement externe à l’aveugle est distinct des résultats des six modèles testés dans cet article. Source : artificialanalysis.ai/video/leaderboard/text-to-video.
━━━━━━━━━━━━━━━━
4. Conseils
1. Envoyez vos prompts en anglais
Tous les modèles comprennent et exécutent l'anglais de manière plus fiable : rédigez vos prompts en anglais, une description de scène en chinois pouvant venir en complément dans le prompt anglais.
2. Ne faites pas la queue en ligne pour Seedance 2.0
L'attente sur la version web est une mauvaise expérience : après une journée entière de file, le temps d'attente n'avait presque pas bougé. Passez plutôt par l'API Volcano Engine.
3. L'appel à l'API exige du code
Utiliser l'API suppose d'écrire soi-même le code d'intégration ; mieux vaut avoir sous la main un assistant de programmation IA, cela facilite grandement les choses. Pour la mise en œuvre, voir la documentation officielle de chaque plateforme.
━━━━━━━━━━━━━━━━
Enregistré lors de nos essais de juin 2026. Les plateformes évoluent si vite que le prochain essai pourrait être complètement différent.
Tout ce qui précède reflète un point de vue de test personnel et n'est donné qu'à titre indicatif.